들어가며
C++98을 통해 표준의 기반은 마련되었지만, 실제 사용이 늘어나면서 기존 C++의 한계도 점차 드러나기 시작했다.개발자의 의도를 코드에 명확하게 표현하기 어려운 경우가 많았고, 자원과 객체의 생명주기를 관리하는 과정 역시 개발자의 세심한 주의에 크게 의존했다.C++은 이러한 문제를 개선하면서도 기존의 성능과 제어 능력은 그대로 유지해야 했다.그리고 2011년, 이러한 요구를 바탕으로 C++은 큰 변화를 맞이한다.이번 글에서는 흔히 Modern C++의 시작이라고 불리는 C++11이 어떤 문제를 해결하기 위해 등장했는지 살펴보고자 한다.
먼저 생각해볼 질문
본문을 읽기 전에 다음 질문에 대해 먼저 스스로 고민해보자.
- 객체가 커질수록 이를 복사하고 전달하는 비용은 어떻게 줄일 수 있을까?
- NULL이 포인터가 아니라 정수 0으로 해석될 수 있는 문제는 어떻게 해결할 수 있을까?
- 하드웨어의 성능이 높아지면서 하나의 작업 흐름만으로 처리하는 방식에는 어떤 한계가 드러났을까?
C++98 이후, 다음 표준을 향한 변화
C++98을 통해 언어와 표준 라이브러리의 기본적인 틀은 마련되었다. 하지만 첫 표준이 완성되었다고 해서 C++의 발전이 끝난 것은 아니었다. 실제 프로젝트에서 C++이 널리 사용되기 시작하면서 언어와 라이브러리의 모호한 부분이나 부족한 기능도 점차 드러났다.
이러한 문제를 정리하기 위해 2003년에는 C++03이 발표된다. C++03은 새로운 기능을 대거 추가한 표준이라기보다는, C++98을 실제로 사용하면서 발견된 결함과 모호한 부분을 수정하고 기존 표준을 정비하는 성격이 강했다.
즉 C++98이 표준 C++의 기반을 만들었다면, C++03은 그 기반을 한 차례 다듬는 과정이었다.
오픈 소스와 라이브러리 생태계의 활성화
한편 C++을 사용하는 개발자와 프로젝트가 늘어나면서 표준 라이브러리 밖의 생태계도 빠르게 성장하기 시작했다. 대표적인 프로젝트가 Boost이다.
Boost는 1998년부터 시작된 C++ 라이브러리 프로젝트로, 1999년 첫 공식 릴리스에서 24개의 라이브러리를 제공했다. 단순히 기능을 모아두는 것이 아니라, 이식 가능하고 재사용할 수 있는 C++ 라이브러리를 공개적으로 제안하고 동료 개발자들의 검토를 거쳐 발전시키는 방식을 사용했다.
이 과정에서 당시 표준 C++에 없거나 부족했던 여러 기능들이 먼저 구현되고 사용되기 시작했다.
특히 shared_ptr, bind, function, type_traits와 같은 기능은 Boost를 통해 실제 환경에서 사용되고 검증되었으며, 이후 TR1(Technical Report 1)에 포함되면서 차세대 C++ 표준 라이브러리의 기반이 된다.
라이브러리만으로 해결하기 어려운 문제
하지만 모든 문제를 새로운 라이브러리를 추가하는 것만으로 해결할 수 있는 것은 아니었다. C++을 사용하는 프로그램의 규모가 커지고 객체가 점점 복잡해지면서, 기존 언어 자체가 가지고 있던 한계도 더 분명하게 드러나기 시작했다.
복사 비용
대표적으로 동적 자원을 가진 객체를 다른 곳으로 전달할 때 발생하는 복사 비용이 있었다. 예를 들어 많은 데이터를 가진 객체를 함수에서 반환한다고 생각해보자.
std::vector<int> CreateData() { std::vector<int> Data(1000000); return Data; }객체를 복사하려면 새로운 메모리를 확보하고 기존 객체가 가진 데이터를 다시 옮기는 과정이 필요할 수 있다. 특히 원본 객체를 이후에 더 이상 사용하지 않는다면 한 가지 의문이 생긴다.
어차피 사라질 객체라면 내부의 자원을 새로 복사하지 않고 그대로 넘겨줄 수는 없을까?
기존 C++에는 이러한 자원의 이동을 일반적으로 표현할 수 있는 언어적 수단이 부족했다.
Null Pointer 해석
Null Pointer 표현 역시 문제였다. C++98에서는 Null Pointer를 표현하기 위해 흔히 NULL을 사용했지만, NULL은 구현에 따라 정수 상수 0으로 정의될 수 있었다. 때문에 Overloading된 함수에서는 개발자가 예상하지 못한 함수가 선택되는 문제가 발생할 수 있었다.
void Print(int Value);
void Print(const char* Value);

Print(NULL);
개발자는 NULL을 사용했기 때문에 Pointer를 받는 함수를 기대할 수 있지만, NULL이 정수 0으로 정의되어 있다면 Print(int)가 선택될 수 있는 가능성도 있었다. 즉 코드에서는 Null Pointer를 표현하고 싶었지만, 언어 입장에서는 정수 0과 Null Pointer의 의도를 명확하게 구분하기 어려웠던 것이다.
이처럼 기존 C++에서는 개발자의 의도를 언어가 충분히 명확하게 표현하지 못하는 경우가 존재했다.
동작 전달의 번거로움
또 다른 문제는 간단한 동작을 다른 함수에 전달하는 과정이 지나치게 장황하다는 점이었다. C++98에서는 STL Algorithm에 간단한 조건이나 연산을 전달하기 위해 별도의 함수나 Function Object를 정의해야 하는 경우가 많았다.
예를 들어 std::sort에 정렬 기준 하나를 전달하기 위해서도 다음과 같이 별도의 객체를 만들어야 했다.
struct Compare
{
    bool operator()(int A, int B) const
    {
        return A > B;
    }
};

std::sort(Data.begin(), Data.end(), Compare());
실제로 필요한 것은 두 값을 비교하는 짧은 동작뿐이지만, 이를 전달하기 위해 별도의 이름과 타입을 가진 객체까지 정의해야 했다.
Template과 STL Algorithm의 사용이 늘어나면서 이런 방식은 Generic Programming의 활용을 더욱 장황하게 만드는 요인 중 하나가 되었다.
하드웨어 환경의 변화
같은 시기 하드웨어의 발전 방향에도 큰 변화가 나타났다.
CPU는 오랫동안 하나의 Core 성능을 높이는 방향으로 발전했지만, 전력 소비와 발열 등의 한계가 커지면서 2000년대 중반부터 여러 Core를 하나의 Processor에 배치하는 Multi-Core 구조가 빠르게 확산되기 시작했다.
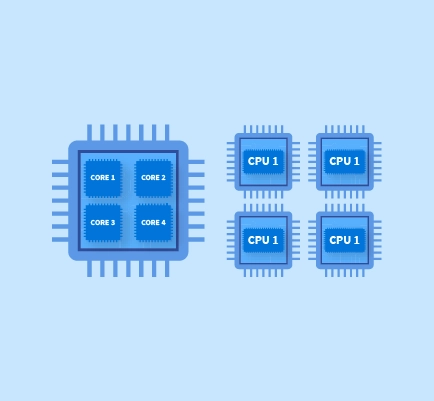
이에 따라 소프트웨어 역시 하나의 작업 흐름만으로는 하드웨어가 제공하는 전체 처리 성능을 충분히 활용하기 어려워졌다.
멀티스레드 프로그래밍 자체는 C++98과 C++03 시기에도 가능했지만, C++ 표준에는 여러 Thread가 동시에 메모리에 접근할 때 어떤 규칙을 따라야 하는지 정의하는 Memory Model이 존재하지 않았다.
따라서 Thread와 동기화 기능은 운영체제나 플랫폼별 API에 의존해야 했다.
C++0x를 향한 논의
결국 C++98 이후에는 여러 방향에서 변화가 요구되기 시작했다.
* 객체의 불필요한 복사 비용을 줄일 방법 * 자원과 객체의 생명주기를 더 명확하게 관리할 방법 * 개발자의 의도를 코드에 더 정확하게 표현할 방법 * Generic Programming을 더 편리하게 사용할 방법 * 멀티스레드 환경을 표준 차원에서 다룰 방법
이러한 문제를 해결하기 위한 제안들은 2000년대 동안 WG21에서 계속 논의되었고, 다음 C++ 표준인 C++0x에 하나씩 통합되기 시작했다. 그리고 오랜 논의 끝에 2011년, 이러한 변화들이 하나의 새로운 표준으로 정리된다.
그 결과가 흔히 Modern C++의 시작이라고 불리는 C++11이다.
Modern C++ : C++11 업데이트
C++11은 2011년에 발표된 C++의 새로운 표준으로, 이전 표준과 비교해 언어와 표준 라이브러리 전반에 걸쳐 큰 변화가 이루어졌다.
단순히 새로운 문법 몇 가지가 추가된 것이 아니라, 기존 C++에서 불편하거나 모호했던 표현을 개선하고 객체와 자원을 보다 효율적으로 관리할 수 있는 기능들이 대거 추가되었다.
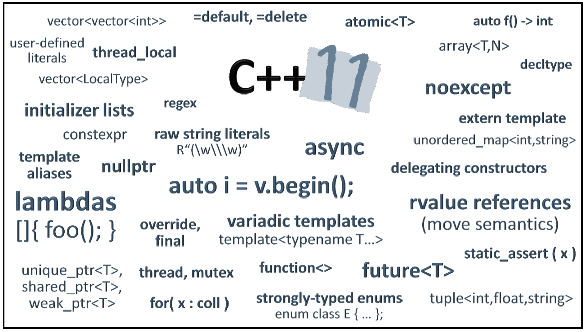
특히 다음과 같은 변화가 핵심이다.
* Null Pointer를 명확하게 표현하기 위한 `nullptr` * 객체의 불필요한 복사를 줄이기 위한 Move Semantics * 복잡한 자료형을 간결하게 표현하기 위한 `auto`, `decltype` * 간단한 동작을 바로 정의하고 전달할 수 있는 Lambda Expression * 객체의 소유권과 생명주기를 표현하는 Smart Pointer * 여러 실행 흐름을 표준에서 다루기 위한 Thread, Atomic, Memory Model * 개발자의 의도를 명확하게 표현하기 위한 `override`, `final`, `enum class` * 컴파일 타임 연산을 확장하기 위한 `constexpr`, `static_assert`
타입과 의도의 명확화
C++11은 개발자의 의도를 더 명확하게 표현하는 기능과 함께, 컴파일러가 이미 알고 있는 타입 정보를 직접 작성하지 않아도 되는 기능도 추가했다.
nullptr
먼저 Null Pointer를 명확하게 표현하기 위한 nullptr가 추가되었다.
Print(nullptr);nullptr는 정수 0과 구분되는 Null Pointer 전용 표현이기 때문에, 개발자가 Pointer를 의도했다는 사실을 컴파일러가 명확하게 판단할 수 있다.
override, final
class Derived : public Base
{
public:
    void Update() override;
};override를 사용하면 해당 함수가 기반 클래스의 Virtual Function을 재정의하기 위한 것임을 명시할 수 있다. 실제로 재정의되지 않는다면 컴파일러가 오류를 발생시키므로, 개발자의 의도와 실제 코드가 어긋나는 문제를 컴파일 단계에서 확인할 수 있다.
virtual void Update() final;final 역시 함수의 추가 재정의나 클래스의 상속을 허용하지 않겠다는 의도를 코드에 직접 표현한다.
auto
타입을 작성하는 방식도 개선되었다.
auto It = Data.begin();auto를 사용하면 컴파일러가 이미 알고 있는 타입을 다시 직접 작성하지 않아도 된다. 또한 decltype을 통해 특정 표현식의 타입을 그대로 얻을 수도 있다.
decltype(Data.begin()) It = Data.begin();이러한 변화들은 개발자가 표현하려는 의미는 더 명확하게 드러내고, 컴파일러가 판단할 수 있는 부분은 컴파일러에게 맡기는 방향으로 C++의 표현력을 확장한 것이다.
이러한 흐름은 enum class, static_assert 등의 기능에서도 이어진다.
Move Semantics
앞서 살펴본 복사 비용 문제를 해결하기 위해 C++11에서는 Move Semantics가 도입되었다. 핵심은 객체가 가진 자원을 새로 복사하는 것이 아니라, 더 이상 필요하지 않은 객체로부터 자원의 소유권을 넘겨받는 것이다.
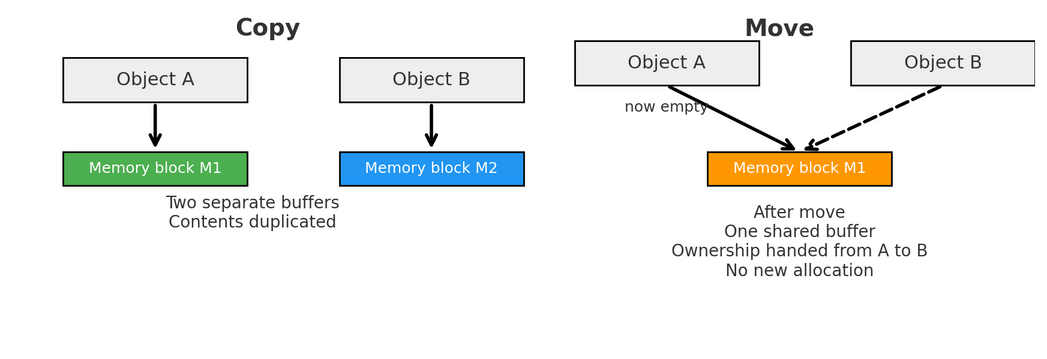
이를 위해 C++11에서는 Rvalue Reference가 함께 도입되었다.
std::vector<int> DataA(1000000);
std::vector<int> DataB = std::move(DataA);std::move를 사용하면 DataA를 이동 가능한 값으로 취급할 수 있게 되고, std::vector의 Move Constructor가 호출되면 DataA가 관리하던 내부 자원을 DataB가 넘겨받을 수 있다.
이때 중요한 점은 std::move 자체가 실제 이동을 수행하는 함수가 아니라는 것이다.
std::move는 객체를 Rvalue로 변환해 이동 대상으로 사용할 수 있도록 만드는 역할을 하며, 실제 자원의 이동은 Move Constructor나 Move Assignment Operator에서 이루어진다.
class Buffer
{
public:
    Buffer(Buffer&& Other) : Data(Other.Data)
    {
        Other.Data = nullptr;
    }

private:
    int* Data = nullptr;
};
위와 같이 Move Constructor는 기존 객체가 가지고 있던 자원을 새로운 객체가 넘겨받고, 원본 객체는 더 이상 해당 자원을 소유하지 않도록 상태를 정리한다.
즉 Move Semantics의 핵심은 단순히 객체를 빠르게 복사하는 것이 아니라, 객체가 가진 자원의 소유권을 이전할 수 있는 의미 체계를 언어 차원에서 제공한 것이라고 볼 수 있다.
이러한 변화는 이후std::unique_ptr처럼 복사는 허용하지 않지만 소유권 이전은 가능한 타입을 구현하는 기반이 된다.
Smart Pointer
C++11에서는 동적 자원의 소유권과 생명주기를 보다 명확하게 표현하기 위해 Smart Pointer가 표준 라이브러리에 포함되었다. Smart Pointer는 Raw Pointer처럼 객체의 주소를 가리키지만, 객체의 생명주기와 소유권을 함께 관리한다는 점에서 차이가 있다.
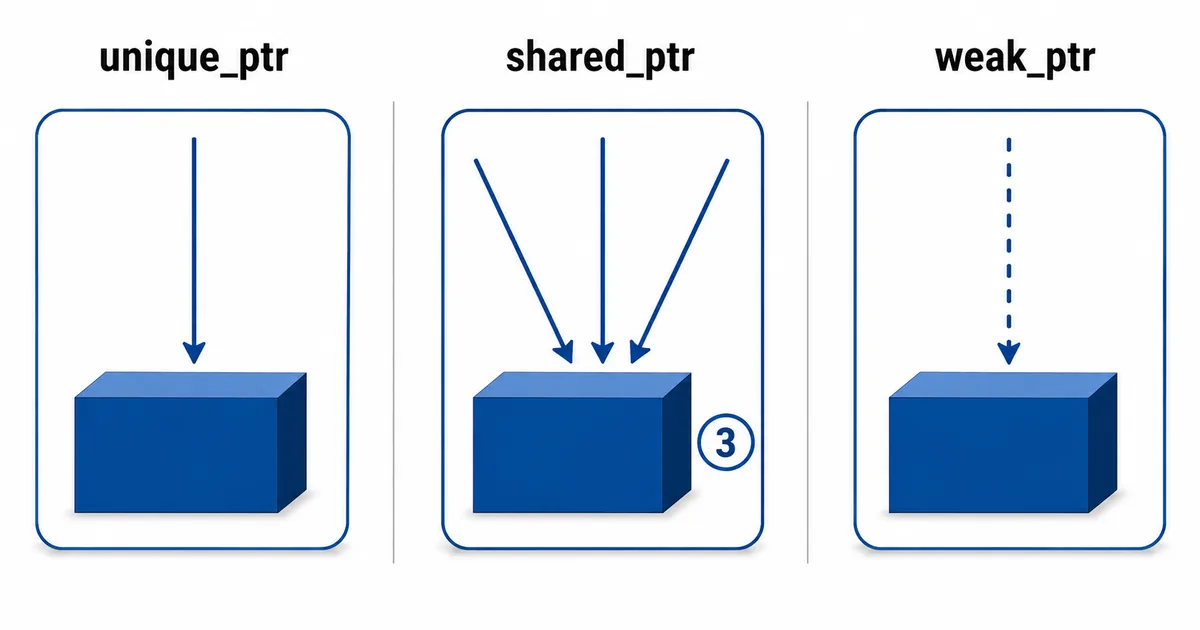
이를 통해 개발자가 직접 delete를 호출하는 부담을 줄이고, 자원의 소유 관계를 코드에 명확하게 드러낼 수 있게 되었다.
unique_ptr
std::unique_ptr는 하나의 객체만 자원을 소유할 수 있도록 하는 Smart Pointer이다.
std::unique_ptr<Player> PlayerPtr = std::make_unique<Player>();unique_ptr가 관리하는 객체는 해당 Pointer의 생명주기가 끝날 때 자동으로 해제된다.
또한 하나의 자원에 하나의 소유자만 존재해야 하므로 복사는 허용되지 않는다.
std::unique_ptr<Player> A(new Player);

std::unique_ptr<Player> B = std::move(A);
대신 Move Semantics를 이용해 소유권을 다른 unique_ptr로 이전할 수 있다. 이 때문에 unique_ptr는 자원의 단독 소유권을 표현하는 가장 기본적인 Smart Pointer로 볼 수 있다.
shared_ptr
std::shared_ptr는 하나의 자원을 여러 객체가 함께 소유해야 할 때 사용한다.
std::shared_ptr<Player> A = std::make_shared<Player>();

std::shared_ptr<Player> B = A;A와 B는 같은 Player 객체를 함께 가리키며, 내부적으로 해당 객체를 소유하고 있는 shared_ptr의 개수를 관리한다.
마지막 소유자가 사라지는 순간 객체가 자동으로 해제된다.
즉 shared_ptr는 Shared Ownership을 표현하기 위한 Smart Pointer이다.
다만 여러 객체가 서로를 shared_ptr로 참조하면 서로의 Reference Count가 0이 되지 않는 Circular Reference(순환 참조)가 발생할 수 있다.
weak_ptr
std::weak_ptr는 객체를 참조하지만, 해당 객체의 소유권에는 참여하지 않는다.
std::shared_ptr<Player> Owner = std::make_shared<Player>();

std::weak_ptr<Player> Observer = Owner;Observer는 Player를 가리킬 수 있지만 Reference Count를 증가시키지 않는다. 따라서 객체의 생명주기를 연장하지 않고 단순히 참조만 유지할 수 있다.
이러한 특성 때문에 weak_ptr는 shared_ptr 사이에서 발생할 수 있는 Circular Reference를 끊거나, 객체를 소유하지 않는 Observer 관계를 표현할 때 사용한다.
정리하면 Smart Pointer는 단순히 delete를 자동으로 호출하는 기능이 아니다.
* unique_ptr는 단독 소유권 * shared_ptr는 공유 소유권 * weak_ptr는 소유하지 않는 참조
를 각각 표현하며, C++에서 자원의 생명주기와 소유 관계를 코드 자체에 드러낼 수 있도록 한다.
Lambda Expression
C++11에서는 간단한 동작을 필요한 위치에서 바로 정의할 수 있도록 Lambda Expression이 추가되었다.
std::sort(Data.begin(), Data.end(), [](int A, int B)
{
    return A > B;
});
기존처럼 별도의 함수나 Function Object를 정의하지 않아도 되므로, STL Algorithm이나 Callback처럼 짧은 동작을 전달하는 코드를 훨씬 간결하게 작성할 수 있다.
int Offset = 10;

auto AddOffset = [Offset](int Value)
{
    return Value + Offset;
};[Offset]과 같이 Capture를 사용하면 Lambda 외부에 있는 변수를 내부에서 사용할 수 있다. 값으로 Capture할 수도 있고, [&Offset]처럼 참조로 Capture해 외부 변수의 변경을 반영할 수도 있다.
Lambda는 이후 Modern C++에서 동작 자체를 값처럼 전달하는 대표적인 표현 방식으로 자리 잡는다.
Thread, Atomic
C++11에서는 멀티스레드 프로그래밍을 표준 차원에서 다룰 수 있도록 Thread Library와 Memory Model이 추가되었다. std::thread를 통해 플랫폼에 독립적인 방식으로 Thread를 생성할 수 있게 되었다.
void Work()
{
    // 작업 수행
}

std::thread Worker(Work);
Worker.join();
또한 여러 Thread가 같은 데이터에 접근할 때 발생할 수 있는 문제를 제어하기 위해 std::mutex와 같은 동기화 도구도 표준 라이브러리에 추가되었다.
std::mutex Mutex;

void Work()
{
    std::lock_guard<std::mutex> Lock(Mutex);

    // 공유 데이터 접근
}
특히 C++11에서는 Atomic Operation을 위한 std::atomic도 함께 도입되었다.
std::atomic<int> Counter = 0;

Counter++;std::atomic을 사용하면 해당 연산을 다른 Thread의 연산과 중간에 섞이지 않는 하나의 원자적인 연산으로 다룰 수 있다.
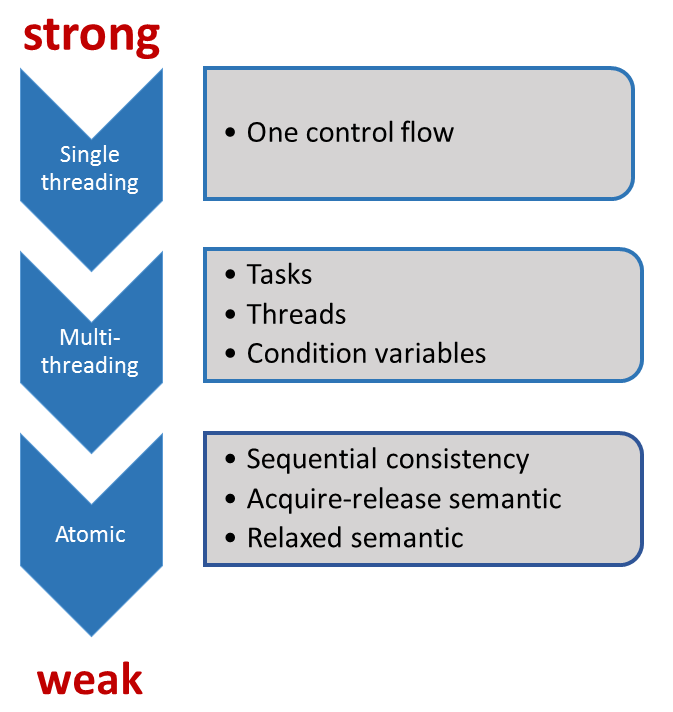
이를 바탕으로 Thread 사이의 메모리 접근 순서와 가시성, Atomic Operation 등의 동작을 표준적인 규칙 안에서 설명할 수 있게 되었고, 여러 Thread가 메모리를 읽고 쓰는 상황을 C++ 표준 자체에서 정의하는 Memory Model이 마련되었다.
즉 C++11부터 멀티스레드 프로그래밍은 특정 운영체제의 기능에만 의존하는 영역을 넘어, C++ 언어와 표준 라이브러리가 직접 다루는 실행 모델의 일부가 되었다.
더 나아가기
여기서부터는 앞에서 배운 개념을 다른 관점으로 확장해본다.
중요한 것은 정답을 맞히는 것이 아니라, 지금까지 살펴본 개념을 바탕으로 충분히 고민하고 자신의 생각을 논리적으로 정리하여 확장해보는 것이다.
C++11에서 가장 중요한 업데이트는 무엇이라고 생각하는가?
나만의 대답
하나의 기능만 고른다면 나는 Move Semantics를 가장 중요한 변화로 보고 싶다.
nullptr, Lambda, auto, Thread처럼 C++11에는 언어의 사용성을 크게 개선한 기능들이 많이 추가되었다. 하지만 Move Semantics는 단순히 새로운 문법 하나가 추가된 것보다 C++에서 객체와 자원을 다루는 방식 자체를 확장했다는 점에서 의미가 크다고 생각한다.
다른 언어의 자원 관리 방식과 비교하면 더욱 특징적이다. Java나 C#처럼 Garbage Collector를 중심으로 메모리를 관리하는 언어에서는 객체를 가리키는 Reference를 여러 곳에서 공유하고, 더 이상 객체를 참조하지 않을 때 런타임이 메모리를 회수하는 방식을 주로 사용한다.
반면 C++은 객체와 자원의 생명주기를 개발자가 보다 직접적으로 제어하는 기존 방식을 유지하면서, 불필요한 복사 없이 자원 자체를 다른 객체에게 이전할 수 있는 방법을 추가했다.
이러한 변화는 단순히 복사 비용을 줄이는 데 그치지 않고, 성능과 세밀한 자원 제어라는 철학을 유지하는 C++만의 독창적인 언어 특징의 기반이 되었다고 생각한다.
C++11은 왜 다른 언어처럼 Garbage Collector 대신 Smart Pointer와 RAII를 발전시키는 방향을 선택했을까?
나만의 대답
나는 C++이 기존에 사용되던 코드와 라이브러리와의 호환성을 최대한 유지하려 했기 때문이라고 생각한다. C++11이 등장했을 당시에는 이미 C++98/03을 기반으로 작성된 수많은 프로그램과 라이브러리가 존재하고 있었다.
만약 메모리 관리 방식을 완전히 다른 방향으로 바꾸거나 Garbage Collector를 언어의 기본 동작으로 강하게 도입했다면, 기존 코드와 라이브러리의 설계 방식에도 큰 영향을 줄 수 있었을 것이다.
반면 RAII는 이전부터 C++에서 사용되던 자원 관리 방식이었고, Smart Pointer는 이러한 기존 방식을 유지하면서 더 안전하고 편리하게 사용할 수 있도록 확장한 기능에 가깝다.
따라서 C++은 기존 생태계와의 호환성을 유지하면서도 자원 관리의 안전성을 높이기 위해, 완전히 새로운 관리 방식을 도입하기보다 RAII와 Smart Pointer를 발전시키는 방향을 선택했다고 생각한다.
C++은 왜 메모리 안전성을 강화하면서도 개발자에게 자원 관리 책임을 계속 남겨두었을까?
나만의 대답
나는 C++이 안전성을 높이더라도 그 과정에서 발생하는 비용과 동작을 개발자가 선택할 수 있어야 한다고 보았기 때문이라고 생각한다.
예를 들어 shared_ptr를 사용하면 객체의 생명주기를 편리하게 관리할 수 있지만, Reference Counting을 유지하기 위한 추가적인 비용이 발생한다. 반대로 모든 객체에 이러한 관리 방식을 강제하지 않는다면, 필요하지 않은 곳에서는 Raw Pointer나 값 객체처럼 더 단순한 방식을 선택할 수도 있다.
즉 C++은 안전한 기능을 기본적으로 제공하되, 모든 프로그램에 동일한 관리 방식을 강제하기보다 상황에 따라 필요한 비용과 관리 방식을 개발자가 직접 선택할 수 있도록 하는 방향을 유지했다고 생각한다.